Dosis inicial: qué medida reportar en un estudio transversal con un desenlace frecuente
Prospecto R n.º 1, dosis inicial. Con la ENDES 2024: por qué el odds ratio exagera la asociación cuando el desenlace es frecuente y cómo calcular la razón de prevalencias en R, a mano, con epiR y con una regresión de Poisson.
Dosis inicial
medidas de asociación
estudios transversales
ENDES
Autor/a
Anthony Romero-Cerdán, MD
Fecha de publicación
3 de septiembre de 2026
Prospecto R es una serie de minitutoriales de análisis de datos de salud en R. Cada entrega responde una pregunta concreta con datos reales del Perú, explica la teoría mínima necesaria y muestra el código completo con sus resultados. Las cifras de este texto se calculan al compilar el documento: no se escriben a mano.
Tip¿Qué dosis te toca?
Cada tema de Prospecto R viene en dos niveles. La dosis inicial tiene lo indispensable para hacer el análisis e interpretarlo bien. La dosis plena tiene todo, incluido lo complejo. Responde:
¿Has ajustado una regresión (logística o de Poisson) en R?
¿Sabes para qué sirven los pesos, los conglomerados y los estratos de una encuesta?
¿Unes dos bases de datos en R sin ayuda?
Si respondiste «sí» a las tres, sigue con la dosis plena. Si alguna fue «no», empieza por la dosis inicial.
Estás en la dosis inicial. Aquí va lo indispensable: elegir la medida, calcularla e interpretarla. Para que el foco esté en eso, se analiza la muestra de la ENDES sin su diseño muestral; al final verás qué cambia cuando se incluye, y la dosis plena lo desarrolla completo.
Nivel
Dosis inicial
Pregunta
¿Qué medida de asociación reporto en un estudio transversal con un desenlace frecuente?
Datos
ENDES 2024, Cuestionario de Salud (INEI)
Paquetes
data.table, epiR, sandwich, lmtest, ggplot2
Requisitos
Saber abrir un archivo en R y qué es una prevalencia
Estás analizando un estudio transversal con un desenlace binario (sí/no) y quieres cuantificar su asociación con una exposición. Si el desenlace es frecuente (como regla práctica, más del 10 %), la medida que responde directamente a tu pregunta es la razón de prevalencias (RP), no el odds ratio (OR).
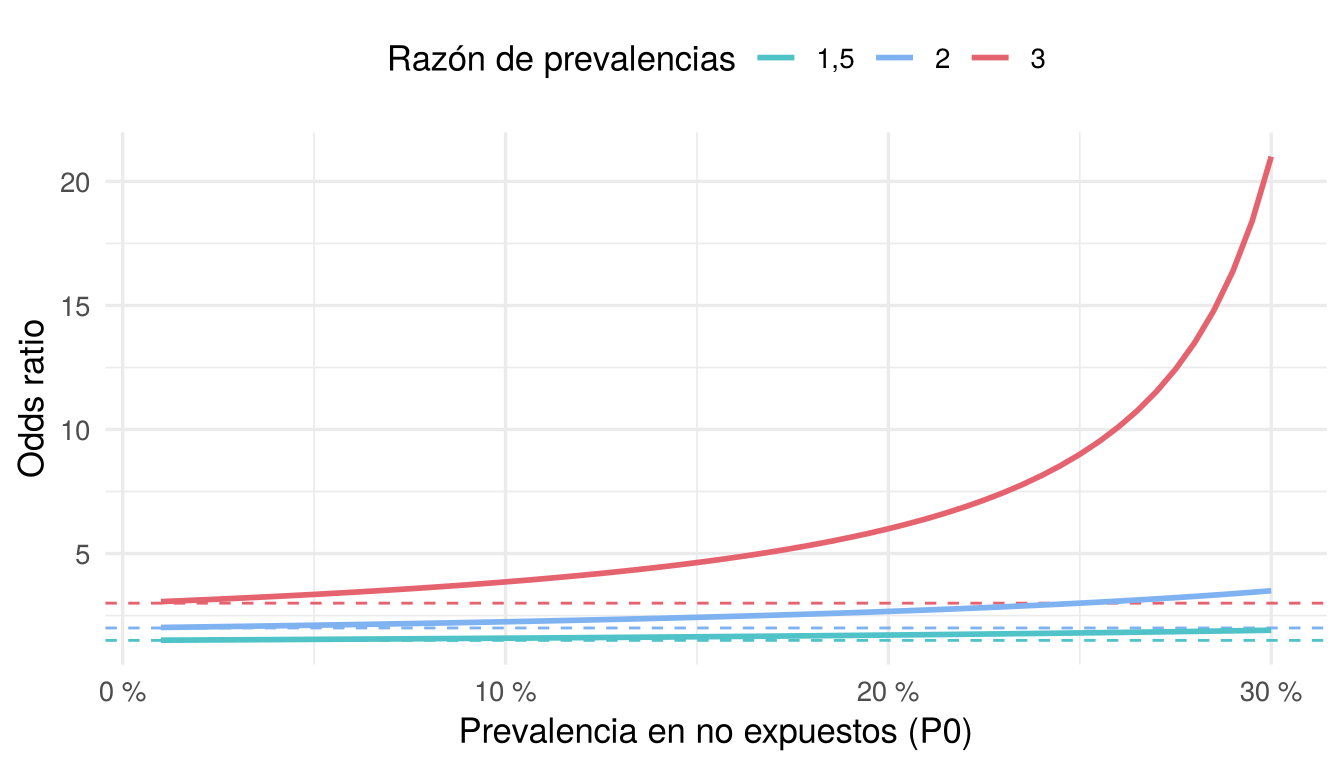
La RP se lee de forma directa: “la prevalencia en expuestos es k veces la de no expuestos”. El OR compara odds (chances: los que tienen el desenlace entre los que no lo tienen), una escala que casi nadie interpreta bien. Cuando el desenlace es raro, las dos cifras se parecen; cuando es frecuente, el OR se aleja de 1 mucho más que la RP:
Figura 1: Para una misma razón de prevalencias, el OR crece a medida que el desenlace es más frecuente.
Las líneas punteadas marcan la RP real. Con una RP de 3 y una prevalencia de 20 % en no expuestos, el OR ya es 6,0.
Posología
La pregunta del ejemplo, con datos de la ENDES 2024: ¿cuánto más frecuente es la obesidad abdominal en las mujeres que en los hombres?
Paso 1. Descarga los datos
En el portal de microdatos del INEI (https://proyectos.inei.gob.pe/microdatos/), elige Consulta por encuestas, luego ENDES y el año 2024, y descarga en formato CSV estos dos módulos:
Módulo
Archivo
Contenido
1640
CSALUD01_2024.csv
Cuestionario de salud de personas de 15 y más años (incluye el perímetro de cintura)
1632
RE223132_2024.csv
Cuestionario individual de mujeres (incluye si está embarazada)
Descomprime los dos archivos dentro de una carpeta ENDES/2024/, junto a tu archivo .qmd. Cada uno crea su propia subcarpeta; en la descarga de 2024 se llaman 968-Modulo1640 y 968-Modulo1632. Si tus datos están en otro lugar o las carpetas tienen otro nombre, cambia ruta en el siguiente bloque de código.
Paso 2. Prepara la base
La obesidad abdominal se define con el perímetro de cintura y los puntos de corte del ATP III: más de 102 cm en hombres y más de 88 cm en mujeres. Hay que excluir a las gestantes, porque en ellas el perímetro abdominal no mide grasa; ese dato está en el cuestionario de mujeres, así que se unen los dos módulos.
Ver código
library(data.table)ruta <-"ENDES/2024"# carpeta con los módulos descomprimidosif (!dir.exists(ruta)) stop("No encuentro la carpeta '", ruta, "'. Revisa el Paso 1 o cambia `ruta`.")# 1. lee solo las columnas que se usansalud <-fread(file.path(ruta, "968-Modulo1640/CSALUD01_2024.csv"), encoding ="UTF-8",select =c("HHID", "QS20C", "QSSEXO", "QS23", "QS907", "QS908", "PESO15_AMAS"))mujer <-fread(file.path(ruta, "968-Modulo1632/RE223132_2024.csv"), encoding ="UTF-8",select =c("CASEID", "V213"))# 2. une los módulos: la mujer se identifica por su hogar (HHID) y su número de líneasalud[, HHID :=trimws(HHID)]mujer[, `:=`(HHID =trimws(substr(CASEID, 1, nchar(CASEID) -3)),QS20C =as.integer(substr(CASEID, nchar(CASEID) -1, nchar(CASEID))))]d <-merge(salud, mujer[, .(HHID, QS20C, V213)], by =c("HHID", "QS20C"), all.x =TRUE)# 3. crea las variablesd <- d[!is.na(PESO15_AMAS)] # personas con entrevista de saludd[, sexo :=factor(QSSEXO, 1:2, c("Hombre", "Mujer"))]d[, edad :=cut(QS23, c(15, 30, 45, 60, Inf), right =FALSE,labels =c("15-29", "30-44", "45-59", "60+"))]d[, gestante :=!is.na(V213) & V213 ==1] # V213 = 1: embarazada ahorad[, cintura :=fifelse(QS908 ==1& QS907 >=55& QS907 <=170, as.numeric(QS907), NA_real_)]d[gestante ==TRUE, cintura :=NA]d[, obes_abd :=as.integer(fifelse(sexo =="Mujer", cintura >88, cintura >102))]# 4. quédate con quienes tienen la medición válidadc <- d[!is.na(obes_abd)]nrow(dc)
Mira el resultado
#> [1] 30493
Es el número de personas que entran al análisis: 30 493. De las 31 304 con entrevista de salud, quedan fuera quienes no tienen una medición válida de la cintura y las 269 gestantes. Anota siempre esta cifra: es la n que reportarás.
QS908 = 1 indica que la cintura se midió; el rango de 55 a 170 cm descarta valores imposibles. Si quieres el detalle de cada variable, está en la dosis plena.
#>         Obesidad
#> Sexo        Sí    No
#>   Mujer  10324  7263
#>   Hombre  2200 10706
Filas: mujeres arriba (expuestas) y hombres abajo (no expuestos).
Columnas: primero quienes tienen obesidad abdominal (Sí) y luego quienes no (No).
Así, 10 324 es la celda a (mujeres con obesidad abdominal) y 10 706 es la d (hombres sin ella).
El orden importa: los expuestos (mujeres) van en la primera fila y el desenlace presente en la primera columna. Así la tabla queda como la de la sección Composición. En el código, c y d se llaman cc y dd porque c() ya es una función de R y d es la base de datos.
Paso 4. Calcula la RP y el OR a mano
Ver código
a <- tab["Mujer", "Sí"]; b <- tab["Mujer", "No"] # expuestascc <- tab["Hombre", "Sí"]; dd <- tab["Hombre", "No"] # no expuestosp1 <- a / (a + b) # prevalencia en mujeresp0 <- cc / (cc + dd) # prevalencia en hombresc(P1 = p1, P0 = p0, RP = p1 / p0, OR = (a * dd) / (b * cc))
Mira el resultado
#>        P1        P0        RP        OR
#> 0,5870245 0,1704634 3,4436992 6,9172984
P1 y P0 son las prevalencias en proporción: 0,5870 es 58,7 % de mujeres con obesidad abdominal y 0,1705, 17,0 % de hombres.
RP = 3,44: la prevalencia en mujeres es 3,44 veces la de los hombres.
OR = 6,92: el cociente de odds, casi el doble de la RP.
Paso 5. Obtén los intervalos de confianza con epiR
Ver código
library(epiR)res <-epi.2by2(tab, method ="cross.sectional")# las dos medidas que interesan, redondeadascbind(res$massoc.summary[1:2, "var", drop =FALSE], round(res$massoc.summary[1:2, -1], 2))
Mira el resultado
#>               var  est lower upper
#> 1 Prev risk ratio 3,44  3,31  3,58
#> 2 Prev odds ratio 6,92  6,55  7,31
var dice qué medida es: con method = "cross.sectional", epiR llama Prev risk ratio a la RP y Prev odds ratio al OR.
est es la estimación; lower y upper, los límites del intervalo de confianza del 95 %.
Si el intervalo no incluye el 1, los datos no son compatibles con la ausencia de asociación. Aquí la RP va de 3,31 a 3,58.
Si escribes solo res, epiR imprime un informe completo en inglés: la tabla con las prevalencias de cada fila (Prev risk, por cada 100 personas) y otras medidas que no hacen falta para esta pregunta, como la fracción atribuible y el valor E. Ese informe mezcla coma y punto decimal; por eso aquí se extraen solo las dos filas que importan.
Paso 6. Haz lo mismo con un modelo
La tabla 2×2 no permite ajustar por otras variables; un modelo sí. Para la RP se usa una regresión de Poisson con varianza robusta. El modelo de Poisson por sí solo da intervalos demasiado anchos con un desenlace binario; la varianza robusta lo corrige.
Ver código
library(sandwich)library(lmtest)m_rp <-glm(obes_abd ~ sexo, data = dc, family =poisson(link ="log"))ic_rp <-coefci(m_rp, vcov. =vcovHC(m_rp, type ="HC0"))exp(cbind(RP =coef(m_rp), ic_rp))["sexoMujer", ]
Mira el resultado
#>       RP    2,5 %   97,5 %
#> 3,443699 3,308582 3,584335
RP es la razón de prevalencias y los otros dos números, su intervalo de confianza del 95 %.
Se toma la fila sexoMujer: el efecto de ser mujer frente a la categoría de referencia, el primer nivel del factor (Hombre).
exp() convierte los coeficientes del modelo, que están en escala logarítmica, en razones.
La RP del modelo es la misma de la tabla. Ahora ajusta por edad, que podría confundir la asociación:
Ver código
m_rp_aj <-glm(obes_abd ~ sexo + edad, data = dc, family =poisson(link ="log"))ic_aj <-coefci(m_rp_aj, vcov. =vcovHC(m_rp_aj, type ="HC0"))rp_aj <-exp(cbind(RP =coef(m_rp_aj), ic_aj))["sexoMujer", ]rp_aj
Mira el resultado
#>       RP    2,5 %   97,5 %
#> 3,532350 3,396382 3,673762
Se lee igual que el anterior, pero ahora la RP compara mujeres y hombres de la misma edad. Pasó de 3,44 a 3,53. Cambió menos de 10 %, un criterio práctico habitual: la edad casi no confunde esta asociación.
m_or <-glm(obes_abd ~ sexo, data = dc, family = binomial)exp(cbind(OR =coef(m_or), confint.default(m_or)))["sexoMujer", ]
Mira el resultado
#>       OR    2,5 %   97,5 %
#> 6,917298 6,548257 7,307138
El mismo formato, pero el primer número es un OR: 6,92, igual al de epiR. No lo leas como “veces más frecuente”.
Resultado
Medida
Estimación
Prevalencia en mujeres
58,7 %
Prevalencia en hombres
17,0 %
Razón de prevalencias
3,44 (IC 95 %: 3,31 a 3,58)
Razón de prevalencias ajustada por edad
3,53 (IC 95 %: 3,40 a 3,67)
Odds ratio
6,92 (IC 95 %: 6,55 a 7,31)
La RP dice que, en la muestra, la obesidad abdominal es 3,44 veces más frecuente en mujeres que en hombres. El OR, 6,92, es 2,0 veces la RP: si se leyera como “7 veces más frecuente”, la asociación quedaría más que duplicada.
Contraindicaciones y reacciones adversas
Leer el OR como una razón de prevalencias. Es el error más frecuente. Un OR de 6,92 no significa “7 veces más frecuente”.
Usar la regresión logística por costumbre. En un estudio transversal con desenlace frecuente, usa la regresión de Poisson con varianza robusta.
Olvidar la varianza robusta. Sin vcovHC(), el modelo de Poisson da la misma RP pero con intervalos demasiado anchos.
Desenlace raro. Si la prevalencia es baja (menos de 10 %), el OR y la RP casi coinciden y la logística es aceptable.
Cómo reportarlo
En la muestra de la ENDES 2024 (n = 30 493 personas de 15 y más años), la prevalencia de obesidad abdominal fue 58,7 % en mujeres y 17,0 % en hombres; la razón de prevalencias fue 3,44 (IC 95 %: 3,31 a 3,58), estimada con regresión de Poisson con varianza robusta.
Si tus datos vienen de un hospital o de una muestra simple, este análisis es el completo. Si vienen de una encuesta con diseño complejo, como la ENDES, sigue leyendo.
Autoevaluación
1. En un estudio transversal, la anemia está presente en el 40 % de los expuestos y en el 20 % de los no expuestos. ¿Cuánto valen la RP y el OR?
Ver respuesta
RP = 0,40 / 0,20 = 2,0. OR = (0,40 / 0,60) / (0,20 / 0,80) = 2,67. Con un desenlace tan frecuente, el OR ya se aleja bastante de la RP.
2. Tu regresión logística da un OR de 2,5 para un desenlace con una prevalencia del 35 %. ¿Puedes escribir “es 2,5 veces más frecuente”?
Ver respuesta
No. Con un desenlace frecuente, el OR exagera la asociación si se lee como razón de prevalencias. Estima la RP con regresión de Poisson y varianza robusta, o reporta el OR como lo que es: un cociente de odds.
3. Ajustaste una regresión de Poisson a un desenlace 0/1 sin varianza robusta. ¿Qué parte del resultado está mal?
Ver respuesta
La RP puntual está bien; lo que falla es el intervalo de confianza, que sale demasiado ancho (y el valor p, demasiado grande). Se corrige con vcovHC(), como en el Paso 6.
Siguiente dosis
NotaLo que esta dosis dejó fuera
Las cifras de arriba describen a las personas entrevistadas, no a la población peruana. La ENDES es una muestra aleatoria, pero no simple: algunas zonas tienen en la muestra más peso del que tienen en la población, y los hogares se eligen agrupados en conglomerados. Para hablar de la población hay que usar su diseño muestral (pesos, conglomerados y estratos). Con él, la prevalencia es 62,0 % en mujeres y 20,3 % en hombres, y la RP es 3,05, no 3,44.
Zou G. A modified Poisson regression approach to prospective studies with binary data. Am J Epidemiol. 2004;159(7):702-6.
Barros AJD, Hirakata VN. Alternatives for logistic regression in cross-sectional studies: an empirical comparison of models that directly estimate the prevalence ratio. BMC Med Res Methodol. 2003;3:21.
Expert Panel on Detection, Evaluation, and Treatment of High Blood Cholesterol in Adults. Executive summary of the third report of the National Cholesterol Education Program (NCEP) Adult Treatment Panel III. JAMA. 2001;285(19):2486-97.
Reproducibilidad
Mira el resultado
#> R version 4.3.3 (2024-02-29)
#> data.table 1.14.10
#> epiR 2.0.99
#> sandwich 3.1.0
#> lmtest 0.9.40
#> ggplot2 3.4.4